AI基础设施需要更多支撑环节
PG关注到,意法半导体在6月发布的Cloud AI专题中,把电源转换、光学连接与控制芯片放在同一基础设施框架讨论。公司介绍了SiC、GaN、800V直流架构及硅光子等技术,希望支持更高密度的AI计算部署。
专题提及PIC100硅光子平台、STM32控制器与BiCMOS电子器件,反映数据中心需求正沿着供电和数据链路展开。AI加速器承担运算,周围的连接、控制和功率器件则决定能量与信息能否有效到达,系统表现来自这些环节共同配合。
算力增加,数据搬运同样重要
大型模型任务往往分布在多个计算单元之间,单个芯片完成工作以后仍需交换信息。如果连接等待增加,即使计算单元具备更高性能,也可能无法按预期提高整个任务的速度。互连因此是观察AI基础设施的重要组成。
光学方案的适用性涉及速率、距离和功耗,还与交换架构及模块集成方式有关。不同层级可以采用不同连接形式,不能只根据一种材料或接口名称判断全部系统。真实收益需要在目标数据路径与负载中测量,并保留具体测试条件。
供电链路需要整体安排
从机房电力入口到芯片工作电压,能量需要经过多个转换环节。每一级损耗都会形成热量,功率密度提高后,电气、散热和结构设计更加紧密地相互影响。改进某一器件有价值,最终仍需核对整条链路。
较高电压的分配架构可以改变电流和布线条件,具体实现则需要配合转换器、保护和管理方式。设计目标是将更多输入能量用于有效计算,同时维持可控温度和稳定运行,因此效率数字应当放回明确工况理解,避免忽略外围系统的影响。
机房资源还受到维护方式影响。光学模块、电源和控制部件在异常时能否被识别、定位和替换,关系到系统可用性。高密度架构如果缺少清楚状态信息,可能让故障排查更困难。因此,性能提升之外,设计也需要考虑人员怎样接近问题,使新增基础能力在持续运营中保持可管理。
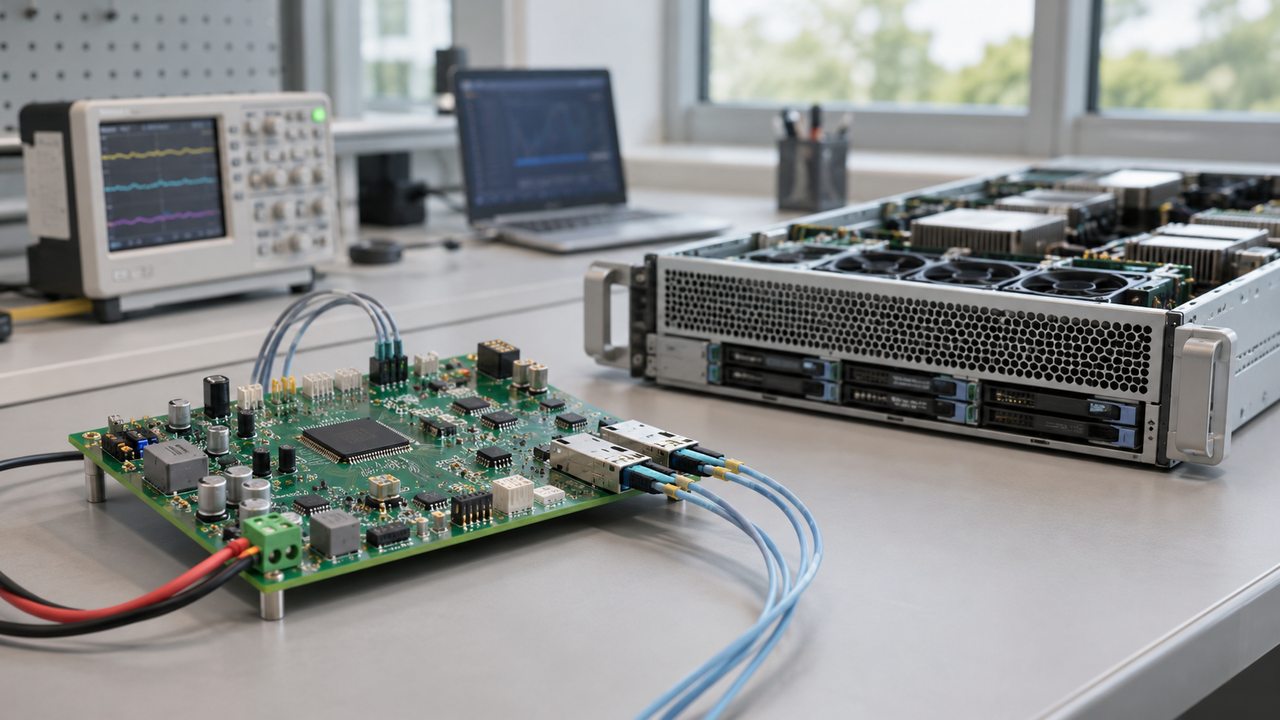
控制层让设备状态可以被观察
光模块和电源模块都需要持续获取温度、电压和运行状态。微控制器及混合信号器件帮助执行配置、监测和保护,使基础设施能够应对负载变化。看似分散的小型控制环节,实际上参与整个系统的可靠运行。
对运营人员,状态信息还需要与资产和时间关联。设备已经运行、数据是否及时,以及告警之后发生了什么,应当能够形成连续记录。这样维护团队才能区分短时变化与持续问题,减少依靠经验猜测设备状态的情况,也便于不同人员接续处理。
系统协作决定基础技术价值
意法半导体把多个技术平台放进同一讨论,展示了器件供应商如何参与AI基础设施演进。不同客户的机架、互连和电源结构并不相同,平台能力还需要通过设计合作、验证和制造配合转化为实际产品。
PG认为,理解云端AI产业链应同时关注算力、数据和能源。后续看点是这些环节怎样协同减少等待与损耗,以及规模部署之后是否便于监测和维护。基础器件的进步需要落到完整系统,才能支持计算资源持续有效地工作。